









人間のレビューは「最後」でいい ー AIによる多層防御
人間のレビューは、あまり早い段階でやるべきではない。これが筆者の持論である。意外に聞こえるかもしれないが、理由はこれまでの3稿で述べてきたとおりだ。
人が早く満足を示すと、品質はそこで止まる。その対話の文脈では、それ以上の品質が追われなくなる。だから、人間のレビューは最後でよい。最後がよい。
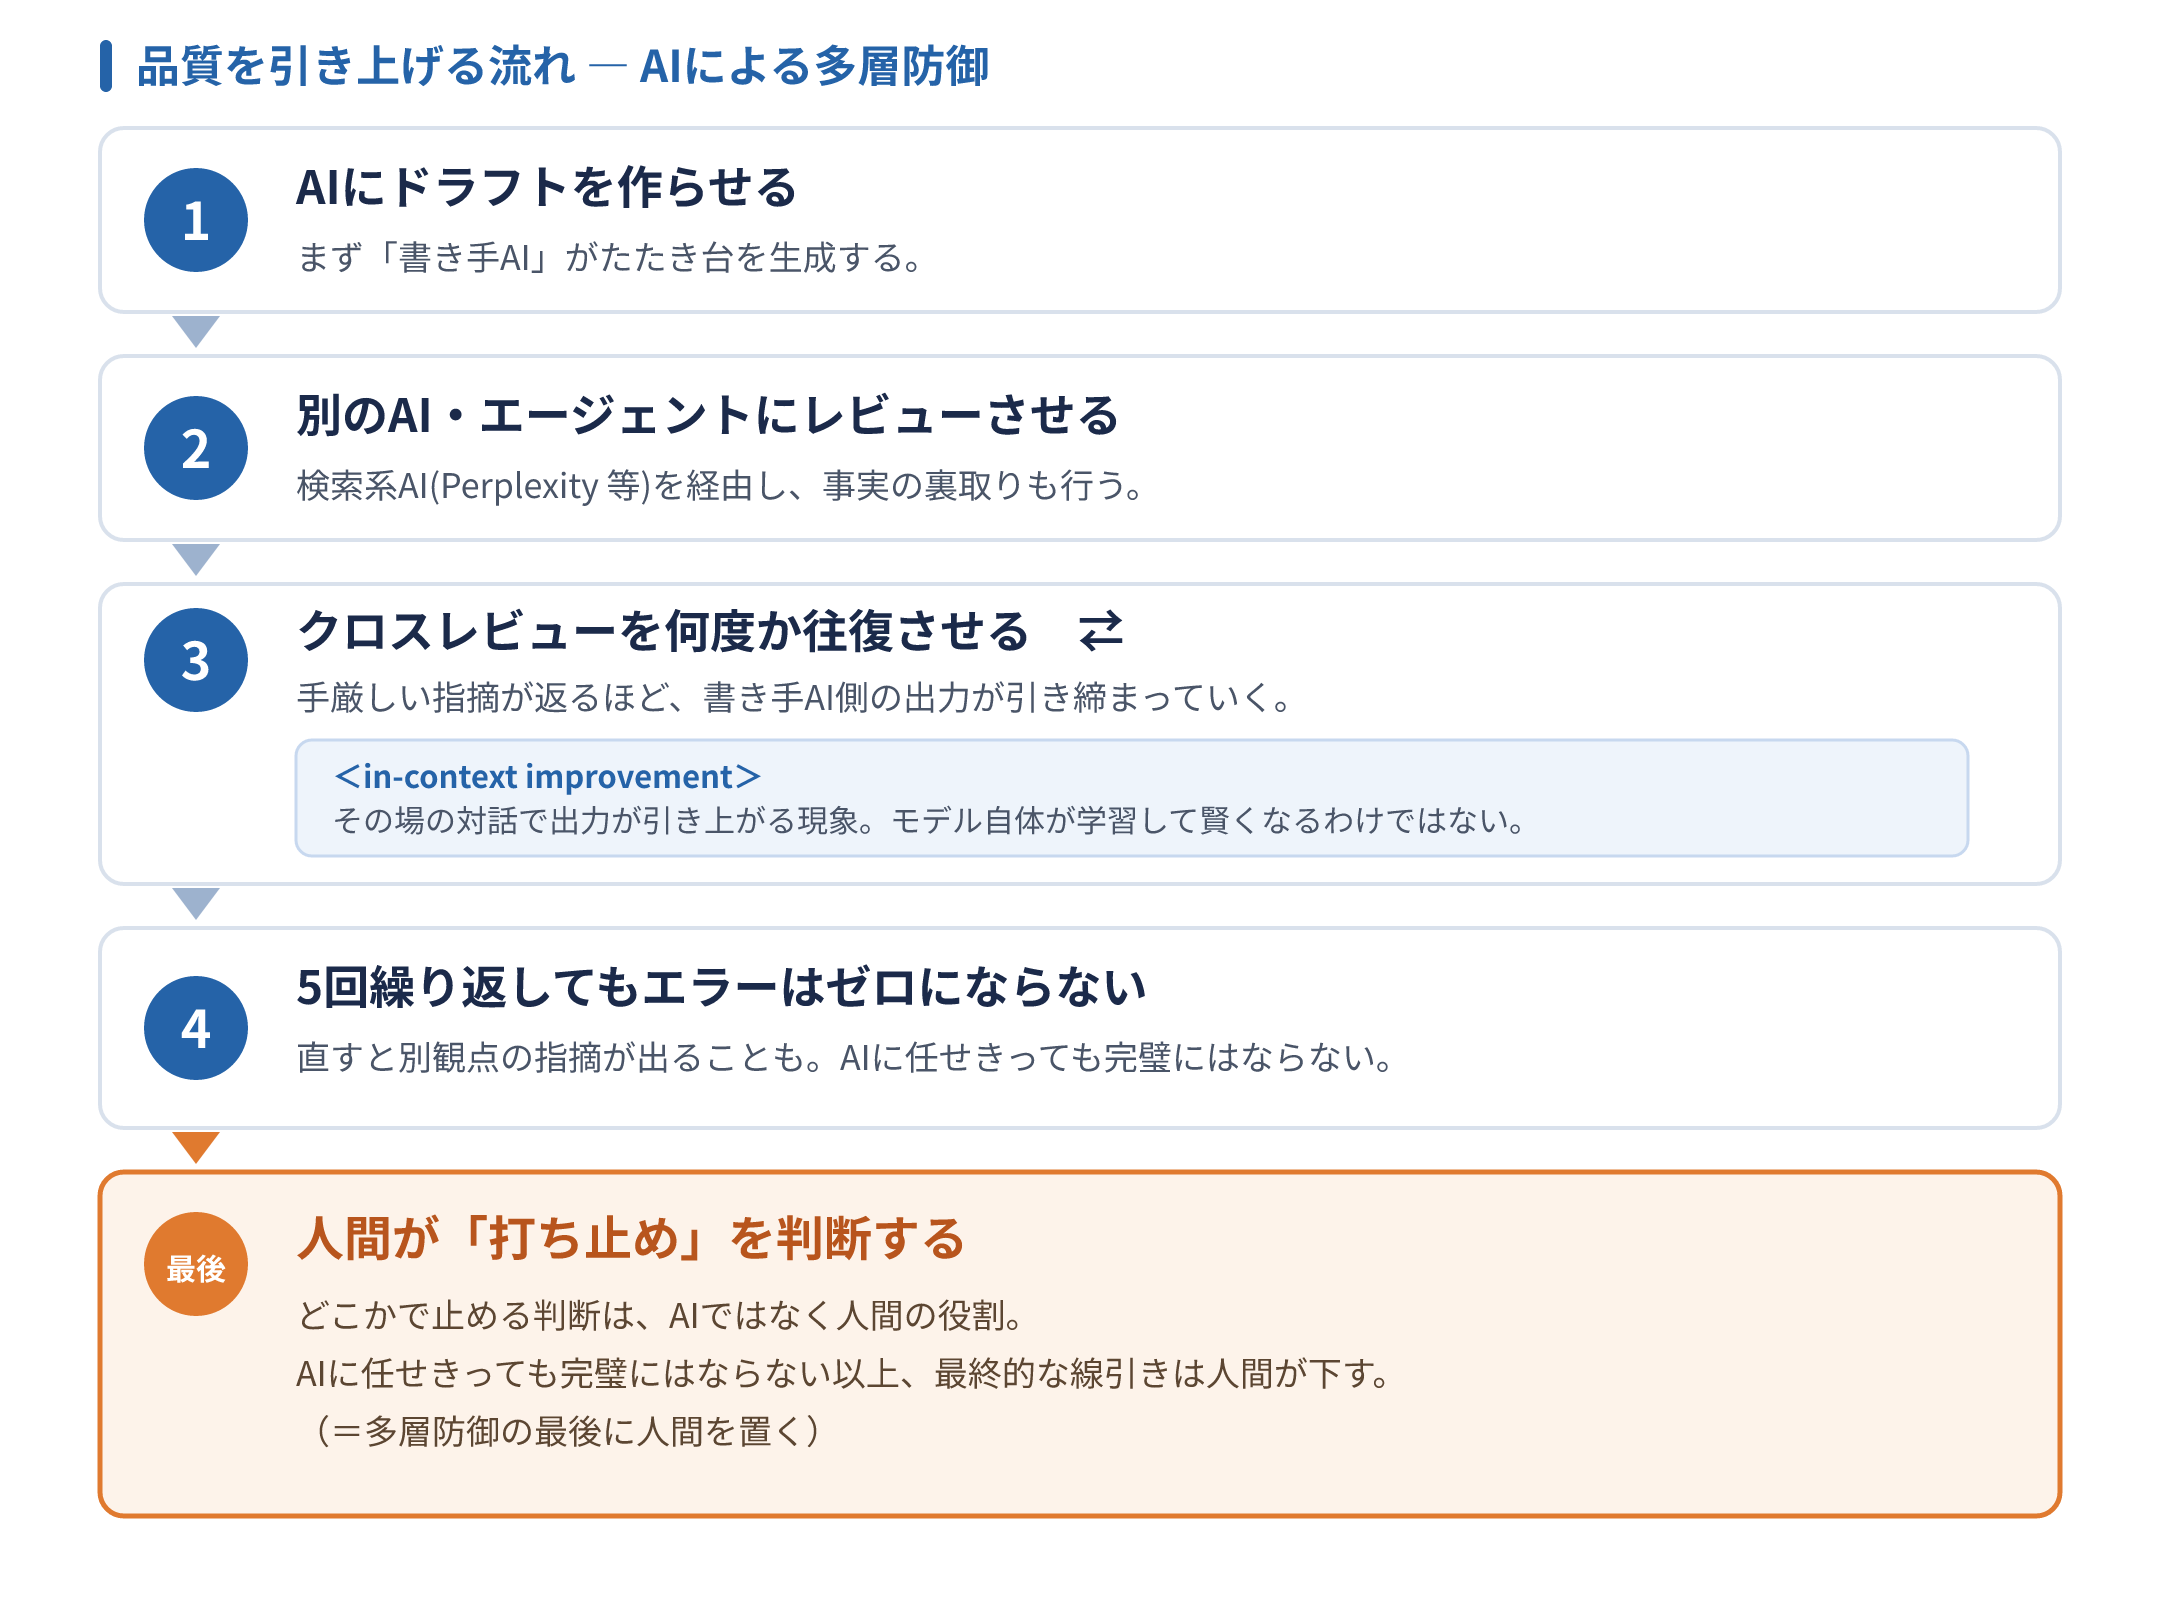
筆者が実際に運用している流れはこうだ。まず生成AIにドラフトを作らせる。それを別のモデル・別のエージェントにレビューさせる。
筆者は検索系AIのPerplexityを経由させて裏取りをすることが多い。そのレビュー結果を、容赦なくドラフト側に返す。人がレビューして甘い結果を返すと要求水準が上がらないが、別のAIは手厳しい指摘を返してくるから、書き手側の生成AIの出力が引き締まる。
これを何度か往復(クロスレビュー)させる。すると、その場の文脈の中で双方の出力がどんどん洗練されていく。ここで一点、誤解のないよう申し添える。
これはモデル自体がやり取りを通じて学習し賢くなるという話ではない。以前のコラムでも述べたとおり、その場の対話で出力が引っ張られる現象(in-context improvement)であって、モデルの中身が成長するわけではないのだ。それでも、批判的な指摘という文脈が積み上がるほど、出力は目に見えて良くなる。これは実際にやってみて気づいたことだ。
ただし、ここに落とし穴がある。筆者は往復を自動化する仕組みを自作して試してみたが、定量的に統計を取ったわけではないものの、実務上の体感として、5回繰り返してもエラーはゼロにならない。それどころか、修正すると別の観点で新たな指摘が見つかり、エラーが増えたように感じることすらある。
つまり、AIに任せきっても完璧にはならない。どこかで「打ち止め」を人間が判断せねばならないのである。
いくつか実務上の勘どころを挙げておく。
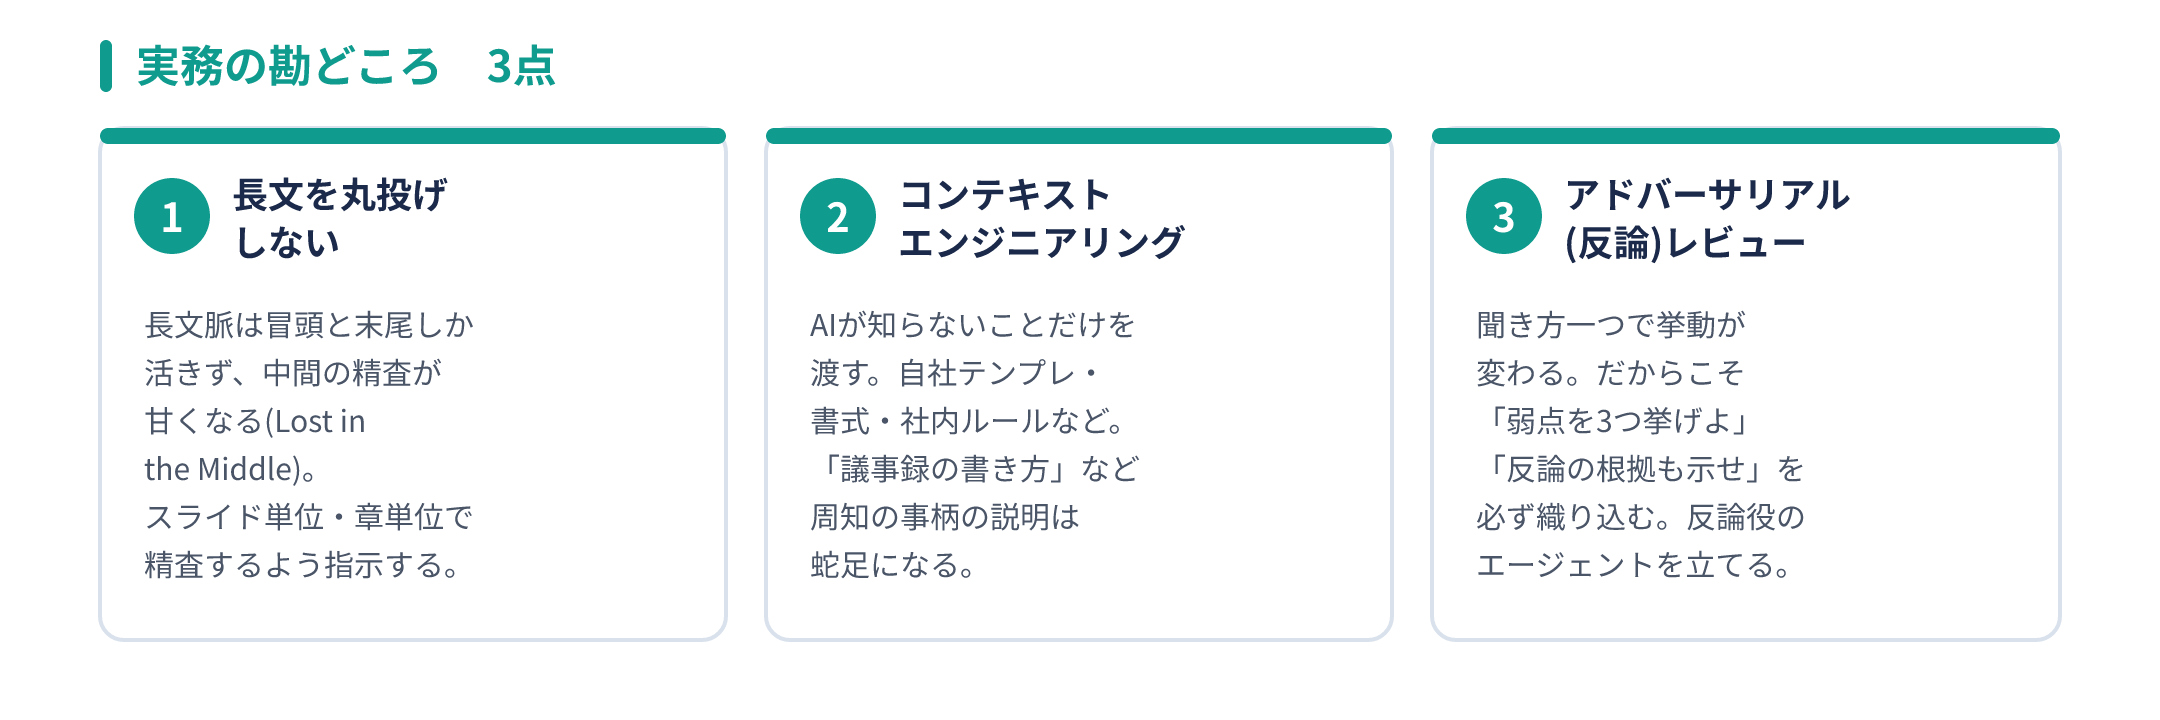
- 第一に、長文を丸ごと投げてはいけない。
AIは長文脈の冒頭と末尾は使えるが、中間の情報の利用性能が著しく低下する。
これがLost in the Middleと呼ばれる現象であり、文脈が長いほど悪化すると報告されている。筆者は経験的にこれを知っていた。PowerPointを丸ごと投げると、頭と尻はチェックするが、真ん中の精査が甘くなりやすい。だから、スライドごと・章ごとに精査するようプロンプトで指示する。 - 第二に、コンテキストエンジニアリングである。
AIに教えるべきは、AIが知らないことーー自社のテンプレートやフォーマット、社内ルールーーであって、議事録の書き方のような周知の事柄ではない。
「議事録にまとめて」と言えば、AIは議事録が何かを当然心得ている。
そこを長々と説明するのは蛇足だ。
逆に、自社の文書テンプレートはAIの知るところではない。
出力をいちいち自社書式に転記し直しているなら、それはコンテキストの渡し方が足りていない証拠である。
プロンプトは曖昧でもよいが、AIが知らない前提だけはきちんと渡す。これだけでもハルシネーションは抑えやすくなる。 - 第三に、アドバーサリアル(反論)レビューである。
「この方針で正しいですよね」と聞けばAIは肯定の根拠を生成し、「誤りですよね」と聞けば否定の根拠を生成する。
同じ内容でも、聞き方で挙動が変わるのだ。
だからこそ「反論側の根拠も示せ」「弱点を3つ挙げよ」を必ず織り込む。
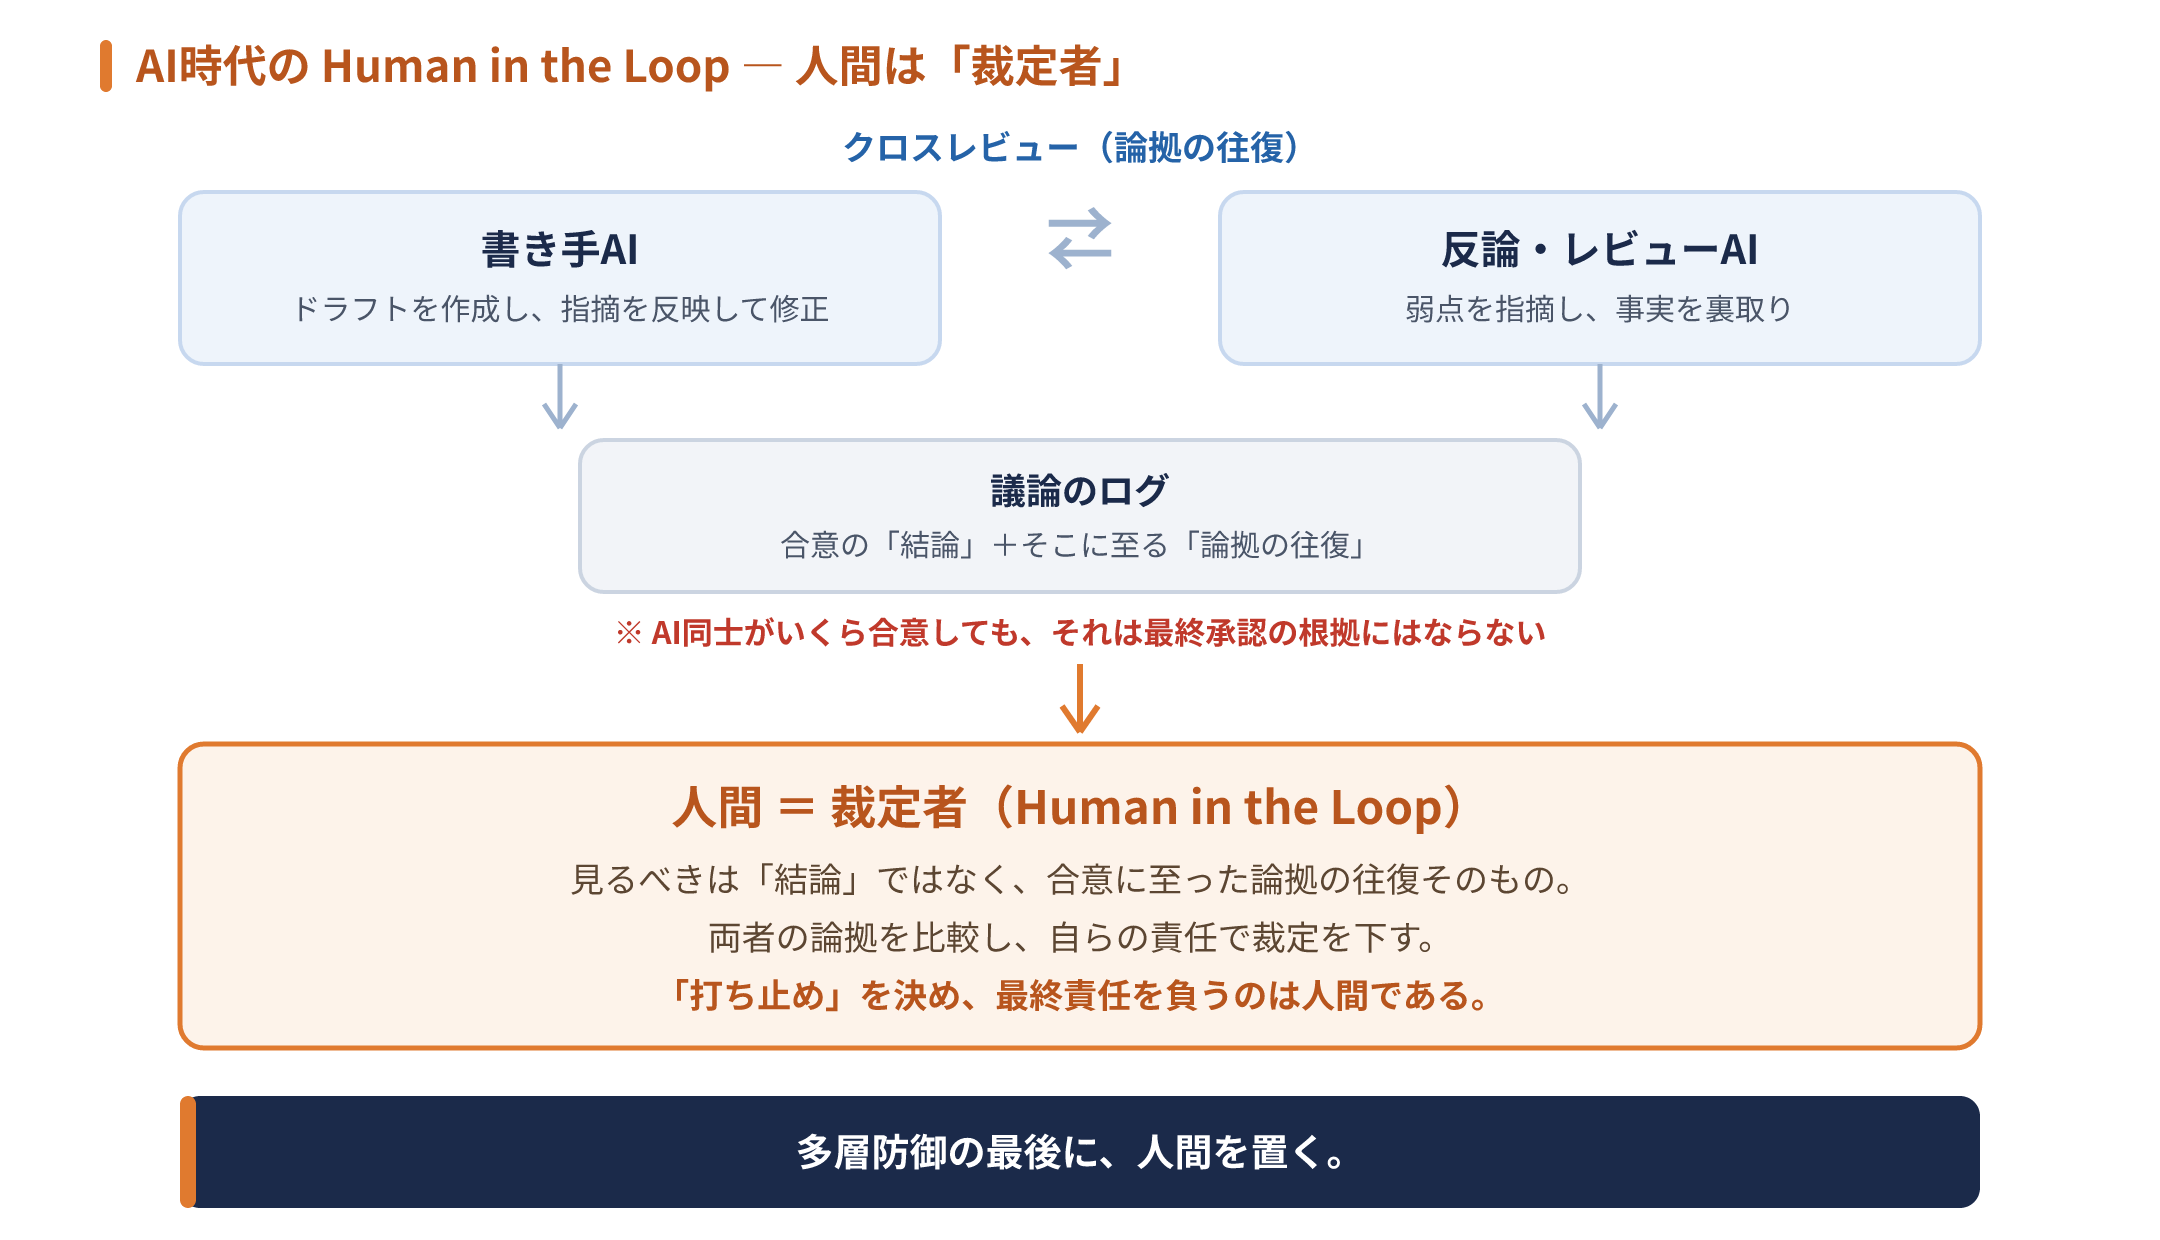
エージェント運用なら、反論専門のレビュアー役を立て、原作者役に反証・修正させ、その議論のログを残す。
ここが最も大切な一点だ。AI同士がいくら合意しても、それは最終承認の根拠にはならない。最終責任は人間が負う。
人間が見るべきは、合意の結論ではなく、合意に至った論拠の往復そのものである。両者の論拠を比較し、自らの責任で裁定を下すーーAI時代のHuman in the Loopは、AI同士の議論を裁く裁定者の役回りなのだ。多層防御の最後に人間を置くとは、そういう意味である。
この分野の解説動画
この記事は参考になりましたか?







この記事へのコメントはありません。