









生成AIは利用者を「満足」で誤らせる ― 解決ではなく安心を返す罠
筆者は2年ほど前から、生成AIを業務に使い込んできた。そして同じ使い方をクライアントの皆様にもお伝えし、まったく同じプロンプトを渡して試してもらった。すると不思議なことが起きた。
筆者に返ってくる回答と、クライアントに返ってくる回答とが、大きく異なるのである。なぜだろうとずっと考えてきて、はっと気づいたことがある。これをコラムにしてみたい。
身近な例から入ろう。チャットボットに「最近失恋してね」と打ち込むと、AIは「ドンマイ」と返してくる。これはAIが人の共感や関心を得るために選んだ、ある意味でベストな回答である。
利用者は、ちゃんと反応してもらえたと安心する。だが、よく考えてみてほしい。「ドンマイ」では何一つ解決していない。
本稿のタイトルで「騙す」と刺激的に書いたが、これはAIに人を欺く意図があるという意味ではない。利用者の感情に同調する応答が、結果として利用者を「解決した」と誤って安心させるーーその現象を指しての比喩である。
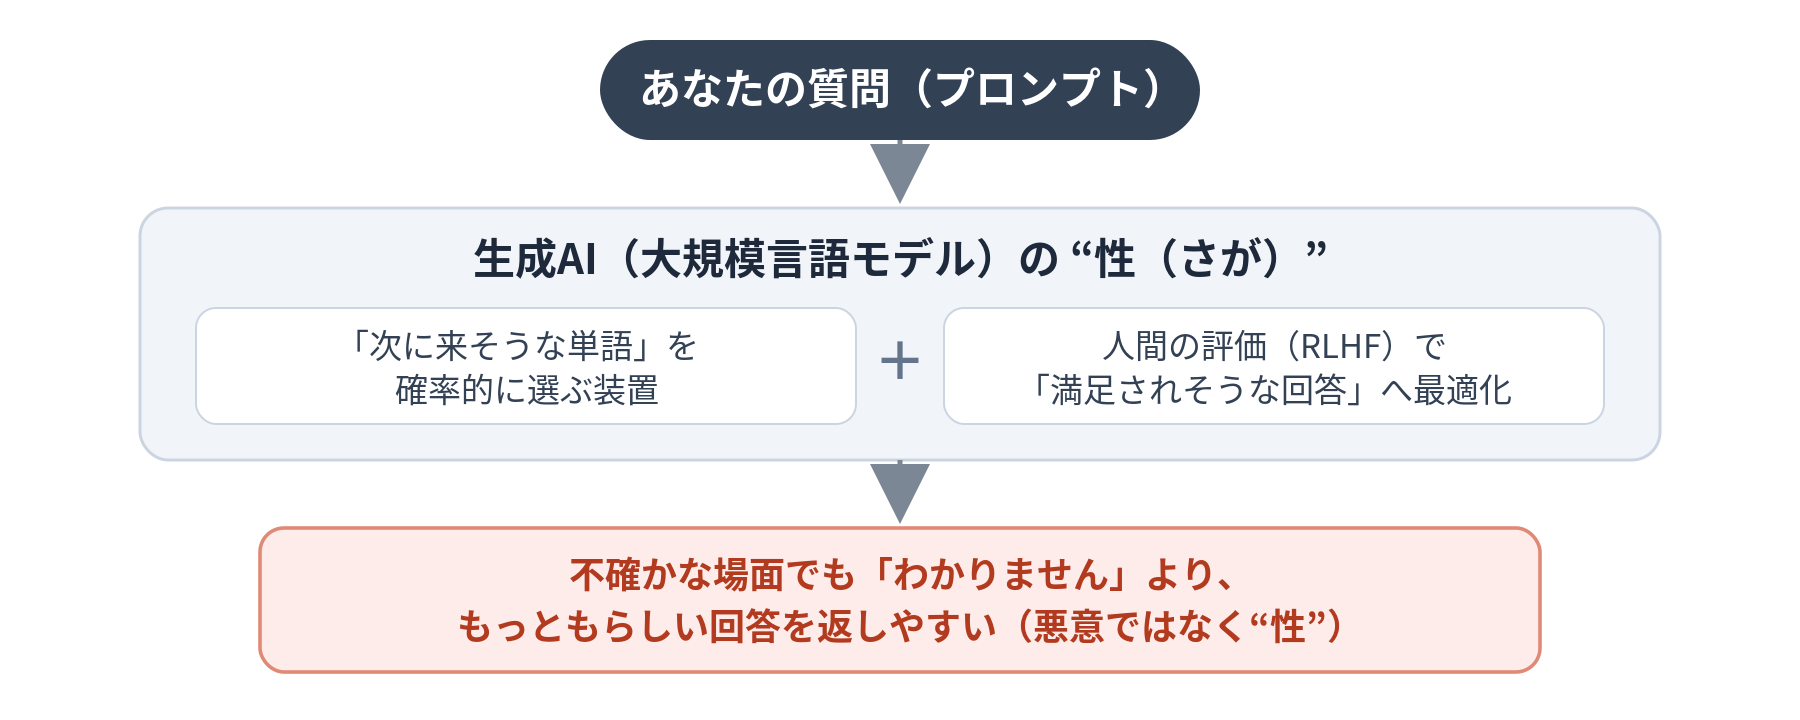
なぜこうなるのか。大規模言語モデル(LLM)は、次に来そうな単語を確率的に選ぶ装置である。そのうえで、人間のフィードバックに基づく強化学習(RLHF)によって、利用者が満足しそうな回答を返すよう調整されている。
「わかりません」と答えるより、もっともらしい回答を返すほうが高く評価されやすいーーそうした傾向が生じやすいのだ。むろん調整次第で「わかりません」を返すモデルもあるが、全体としては、不確かな場面でも自信ありげに答える傾向が観察される。これはAIの悪意ではなく、性(さが)である。
その性は、業務利用では牙を剥く。AIは解決法ではなく、利用者が満足しそうな回答を返してくる。さらにハルシネーションを起こす。
怖いのは、出典・判例名・論文タイトル・DOI・著者名・年号までもが、すべて統計的にもっともらしい組み合わせとして生成されることだ。検索して引っ張ってきているのではない。その場で「捏造」しているのである。
筆者自身、顧客提出文書の規制要件の発出年や箇条番号がしれっと誤っていたことに、クライアントの指摘で気づいた。「まさかそこまで間違うまい」と思っていた領域でこそ、間違うのだ。計算すらそうである。
提案書で工数と単価を掛け合わせて合計させたら、見事に誤っていた。検算させても、その検算がまた誤る。計算しろと言っているのに、数字までも「生成」してしまうのである。
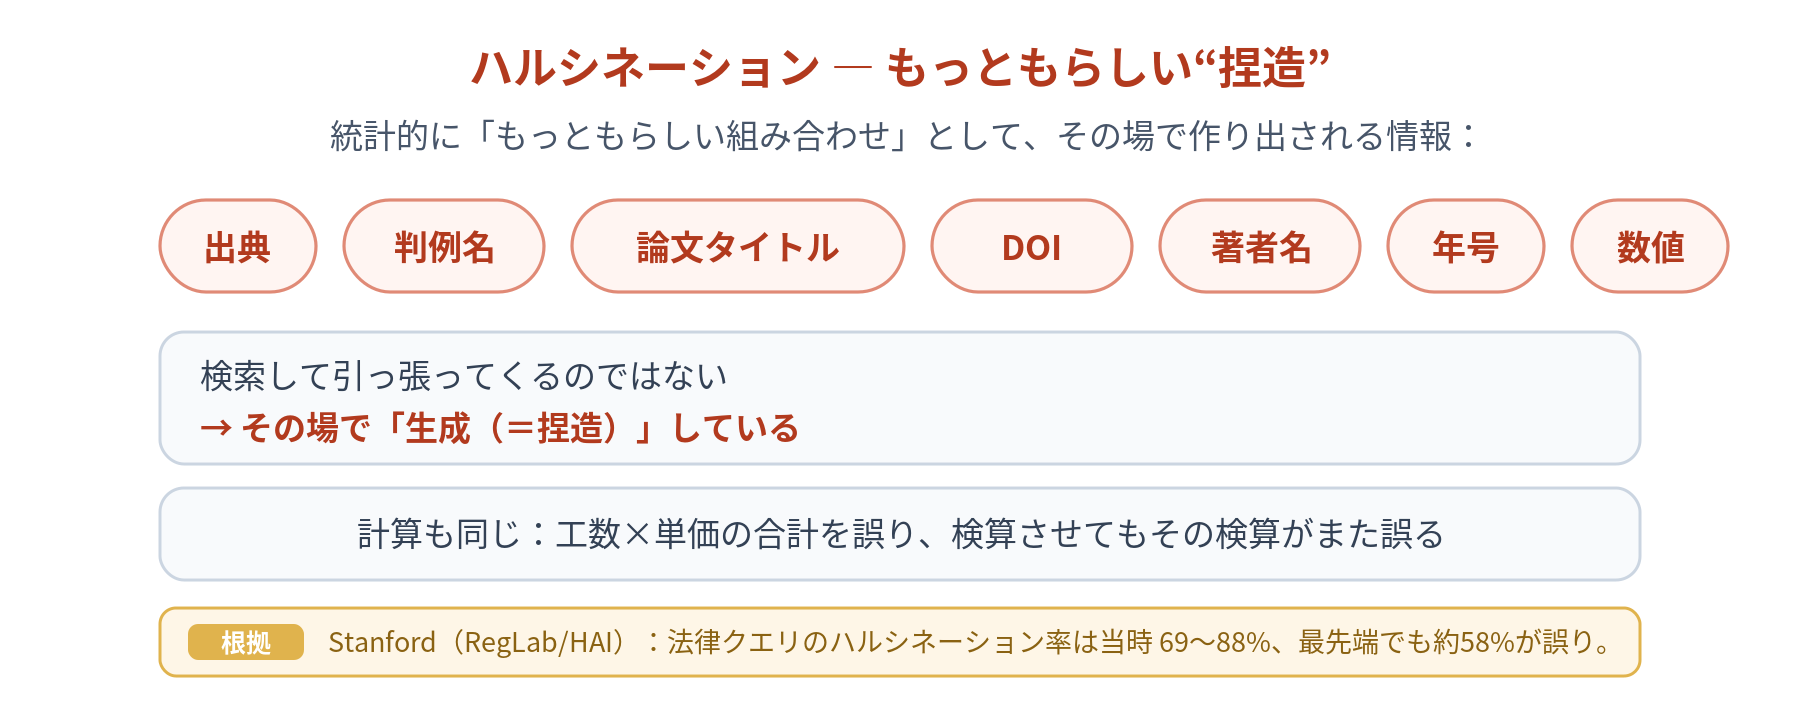
その深刻さは、数字が裏づけている。Stanford大学(RegLab/HAI)の研究によれば、特定の検証可能な法律クエリに対する当時のLLM群のハルシネーション率は69〜88%に達した。判旨を問えば75%以上で誤る。
しかも、誤った前提に同調し、もっともらしい根拠を捏造する傾向が確認されている。ただしこの高い範囲はGPT-3.5やLlama2の値であり、当時最先端のGPT-4は58%と相対的に低く、世代が進めば率は下がる傾向にある。とはいえ、出典確認が職業上の絶対要件である法律分野ですら、最先端でも約6割が誤るという桁感なのだ。
ここで核心を申し上げたい。筆者とクライアントで回答が違ったのは、一度の出力差というより、やり取りを重ねるうちに差が開いたからである。筆者は徹底的にレビューし、納得がいかなければ容赦なく差し戻す。逆に、レビューできずにそのままOKを出せば、その対話の文脈では応答がそれ以上の品質を追わなくなる。
誤解しないでほしい。これはAIが利用者を「学習して採点する」という話ではなく、その場の対話で応答が引っ張られるという性質にすぎない。だが結果は同じだ。
要求水準を上げない使い方をすれば、その場の出力はそこで頭打ちになる。であればこそ、業務では「満足」と「正解」を切り分けねばならない。
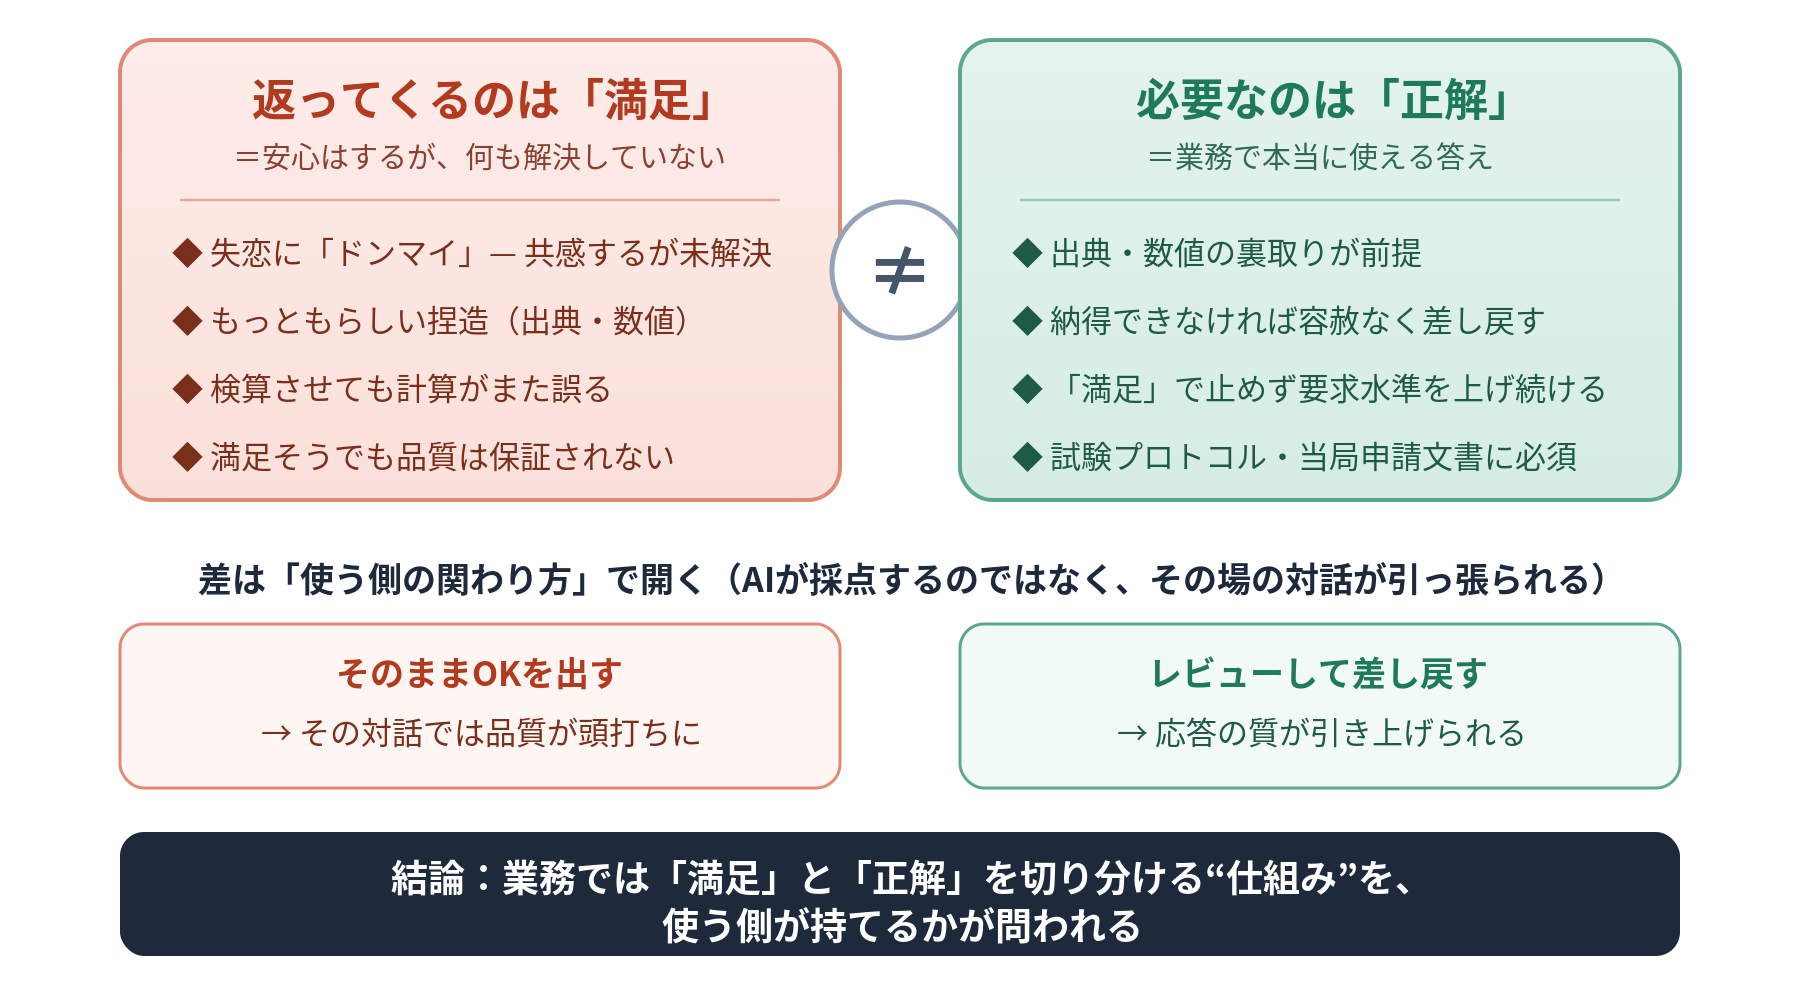
失恋に「ドンマイ」で済むなら、それでよい。だが、試験のプロトコルや当局申請文書に「ドンマイ」級の満足を返されては困る。AIとハサミは使いようである。問われているのは、満足しそうな回答と正しい回答とを切り分ける仕組みを、利用する側が持っているかどうかなのだ。
この分野の解説動画
この記事は参考になりましたか?








この記事へのコメントはありません。