









トランスフォーマーアーキテクチャとは
Transformer——LLMを生んだ「注意」という発明
すべては翻訳から始まった
私たちが日常的に使うようになった大規模言語モデル(LLM)は、たった一つの技術的発明の上に成り立っている。2017年にGoogleの研究チームが発表した「Transformer(トランスフォーマー)」というアーキテクチャである。論文のタイトルは「Attention Is All You Need(必要なのは注意だけ)」という、いささか挑戦的なものであった。
Transformerが生まれた背景には、機械翻訳の精度を上げたいという、きわめて実用的な動機があった。当時のGoogle翻訳は、まだぎこちない訳文を返すことが少なくなかった。研究者たちが取り組んでいたのは「ある単語の後に、どのような単語が続く確率が高いか」を数学的にモデル化するという課題である。
この「次に来る単語を確率で当てる」という発想は、実はとても素朴なものである。膨大な文章を読み込ませ、この確率をひたすら学習させる。それが言語モデルの原型であった。
「順番に読む」ことの限界
しかし、この確率的アプローチだけでは、自然な文章は生まれない。なぜなら、言葉の意味は直前の単語だけでは決まらないからである。たとえば「その銀行は川のそばにあった」という文を考えてみたい。
「銀行」という単語だけを見ても、それが金融機関なのか、あるいは別の何かなのかは判断できない。「川のそば」という後ろの情報まで読んで、はじめて文全体の像が結ばれる。Transformer以前に主流だったRNN(再帰型ニューラルネットワーク)やLSTMは、文章を先頭から順番に一語ずつ読み進める仕組みであった。人間が本を読むのに近いといえば聞こえはよいが、これには二つの弱点があった。
- 第一に、文が長くなると、前のほうの情報を忘れてしまう。伝言ゲームのように、情報が後ろへ渡っていく途中で薄まってしまうのである。
- 第二に、順番に処理するしかないため、計算を並列化できない。一語目の処理が終わらなければ二語目に進めないので、どれだけ高性能な計算機を並べても速くならなかった。
自己注意機構——文全体を一度に見渡す
Transformerが持ち込んだ革新が、自己注意機構(Self-Attention)である。これは、文章を先頭から順に読むのをやめ、文中のすべての単語を同時に見渡したうえで「いま処理している単語は、他のどの単語と強く関係しているか」を計算する仕組みである。先ほどの例でいえば「銀行」という単語を処理するとき、モデルは文中の「川」「そば」「あった」といった単語すべてに目を配り、そのうち「川」に対して高い重みを割り当てる。この重みこそが「注意(Attention)」であり、どこに注目すべきかをモデル自身がデータから学習していく。
【たとえるなら】会議の途中で誰かが「その件ですが」と発言したとする。出席者は、その「その件」が三十分前の誰の発言を指しているのかを、無意識に探し当てている。全員の発言を記憶の中で一望し、関連度の高いものに焦点を合わせる——自己注意機構がやっているのは、まさにこの作業の数学的な再現である。
技術的には、各単語を「Query(問い合わせ)」「Key(見出し)」「Value(中身)」という三つの役割に変換し、QueryとKeyの相性を計算することで重みを決める。図書館で調べ物をするとき、探したいテーマ(Query)と本の背表紙(Key)を照合し、合致した本の中身(Value)を読む、という流れに近い。さらにTransformerは、この注意の計算を複数並行して行う。
これをマルチヘッド注意と呼ぶ。ある系統は文法的な係り受けに、別の系統は意味的な結びつきに注目するというように、複数の視点から同時に文を眺められる。
並列化がもたらした大規模化
自己注意機構には、精度以外にもう一つ、決定的な利点があった。すべての単語を同時に処理できるため、計算をGPU上で大規模に並列化できるのである。順番待ちが消えたことで、学習にかけられるデータ量とモデルの規模を、桁違いに大きくできるようになった。
この「大きくすればするほど賢くなる」という性質が、今日のLLM開発競争の起点となった。GPTシリーズもBERTも、すべてTransformerの子孫である。なお、単語を同時に処理すると語順の情報が失われてしまう。
「犬が人を噛んだ」と「人が犬を噛んだ」の区別がつかなくなるからだ。そこでTransformerは、各単語に位置情報を数値として加算する位置エンコーディングという仕組みを併せ持っている。もともとのTransformerは、翻訳という目的に沿って、原文を読み取る「エンコーダ」と訳文を生み出す「デコーダ」の二部構成であった。その後、文章の理解にはエンコーダ側、文章の生成にはデコーダ側と、用途に応じて片方だけを使う流儀が定着し、今日の対話型LLMの多くは後者を発展させたものである。
「次の一語」を予測し続ける機械
冒頭で触れた「次に来る単語を確率で当てる」という発想は、Transformerの登場によって捨てられたわけではない。むしろ両者が組み合わさったことにこそ、LLMの本質がある。今日のLLMも、やっていること自体は変わらない。
違うのは「文脈」の捉え方である。直前の数語ではなく、数千語、数万語にわたる文章全体を自己注意によって見渡したうえで、次の一語の確率を計算しているのである。
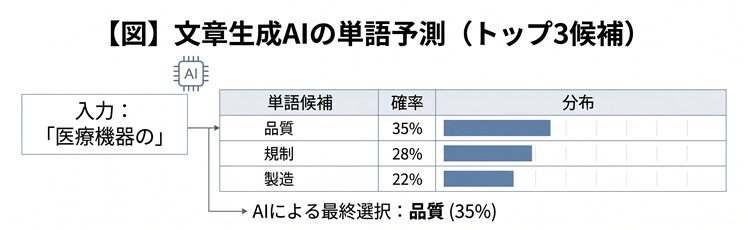
モデルはこのように候補ごとの確率を算出し、そのなかから一語を選び取る。選んだ語を含めた文脈から、また次の一語の確率を計算する。この積み重ねが、人間が書いたかのような文章を生む。
本質的な特性
意味を真に理解して文章を作成しているわけではない膨大なテキストから学んだ統計的なパターンに基づいて出力を生成しているこの特性を理解することが、適切な活用の鍵となるこの性質を踏まえると、LLMの得意・不得意も見えてくる。文脈に沿った自然な文章を紡ぐことは得意である一方、モデルは「正しいこと」ではなく「もっともらしいこと」を選んでいるにすぎない。事実と異なる内容を、いかにも自然な文体で書いてしまう現象——いわゆるハルシネーション——が起きるのは、この確率的な性質に由来する。出力を鵜呑みにせず、人間が確認する工程を必ず残しておく必要がある。
おわりに
Transformerの本質は、驚くほど単純な問いに集約される。すなわち「この単語を理解するために、どこを見ればよいか」である。順番に読むことをやめ、文全体を一度に見渡して重要な箇所に注意を向ける。
この発想の転換が、翻訳の改善という目的を超えて、言語を扱う人工知能そのものの姿を塗り替えた。発表から十年近くを経た現在も、画像認識や生命科学の分野に至るまで、応用範囲は広がり続けている。LLMを使いこなすうえで、その内部構造を細部まで知る必要はない。しかし「モデルは文脈全体に注意を配りながら次の言葉を選んでいる」という一点を理解しておくだけでも、なぜ指示の書き方(プロンプト)が出力の質を大きく左右するのかが、腑に落ちるはずである。
この分野の解説動画
この記事は参考になりましたか?






この記事へのコメントはありません。